Mindre Bits - Mer Modell
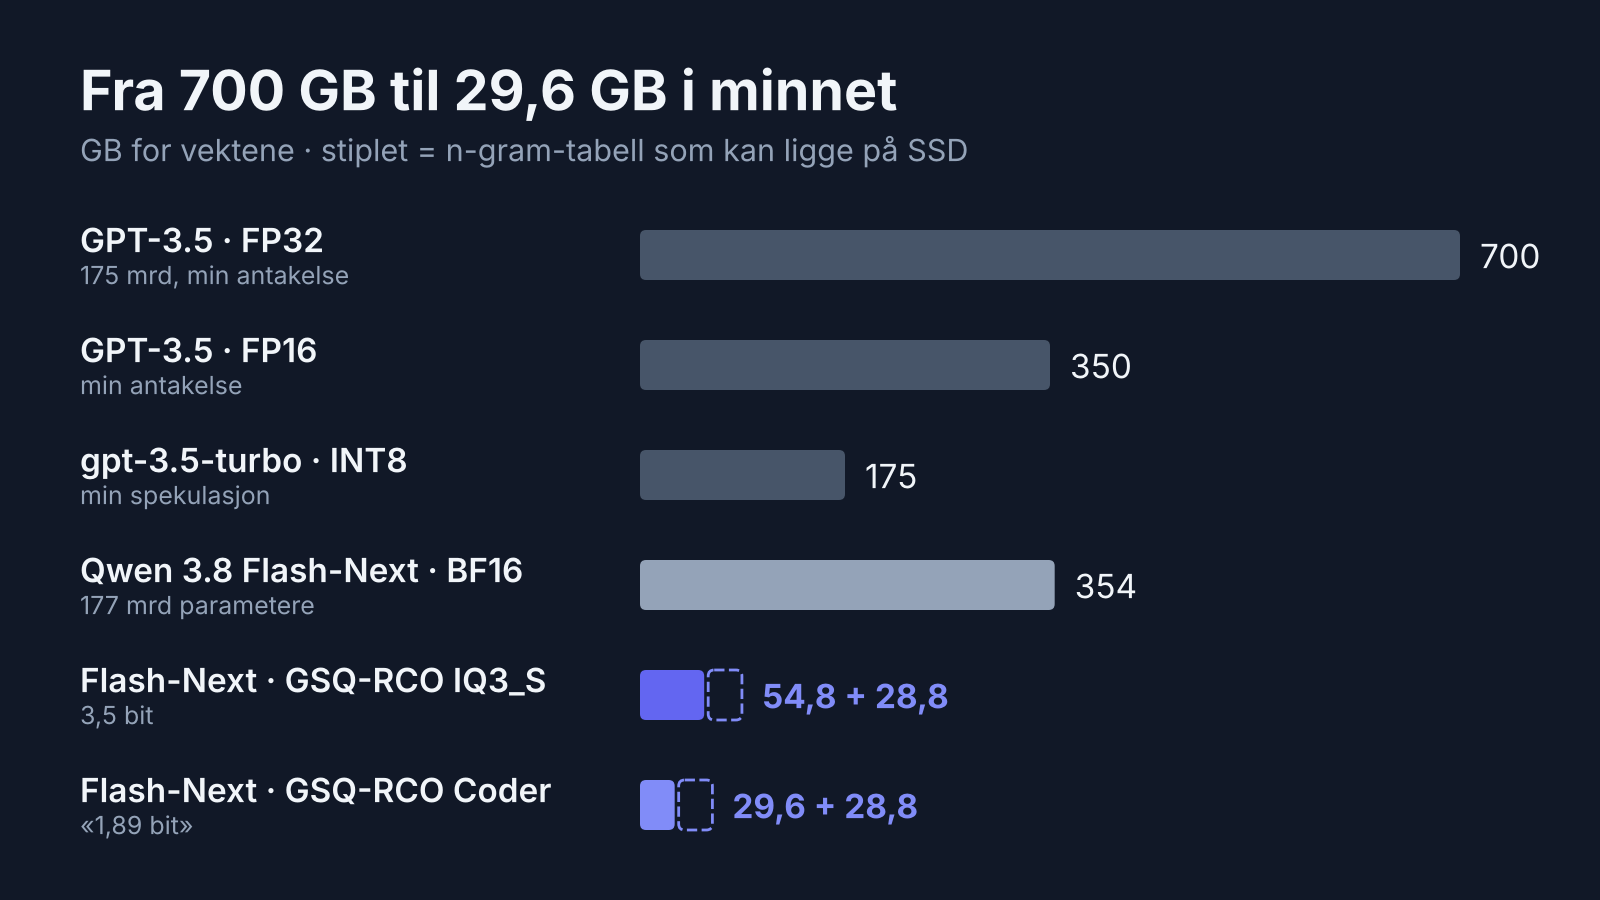
I 2022 trengte en språkmodell et datasenter og rundt 700 GB minne. I dag kjører en modell på 177 milliarder parametere på en Mac Studio, med under 30 GB minne. Fire grep har gjort det mulig: krympe, kutte, flytte og gjette.
Lysbildene til fagdagen ligger her.
Alle fire grepene angriper samme flaskehals: hvor mange bytes maskinen må flytte for hvert token.
- Krympe – færre bits per vekt.
- Kutte – færre vekter.
- Flytte – noen vekter slipper å ligge i raskt minne.
- Gjette – flere tokens hver gang modellen leses.
Dette innlegget er den skrevne versjonen av foredraget Mindre bits. Mer modell. fra fagdagen til JPro 30. oktober 2026. Utgangpunktet var Lithos-metal sitt løfte om 200 tokens per sekund på laptop maskinvare: lithos-metal. 200 t/s er t teoretisk maksimum, men modellene oppnår likevel imponerende resultater - over 100 t/s for 27B modellen og 45 t/s for 115b Flash-Next modellen.
Hvorfor i det hele tatt lokalt?
Det er flere årsaker til å kjøre lokalt (på egen infrastruktur). Ofte er det fordi noen data ikke kan forlate huset på grunn av sikkerhet eller personvern, men også rene sikkerhetskrav kan gjøre lokale KI modeller interessante. I foredraget mitt om Er KI-satsingen din et investorsubsidiert selvbedrag? som jeg holdt på Kongsberg Agenda tidligere i år argumenterte jeg for at vi bygger kritisk infrastruktur på toppen av priser og modeller vi ikke kontrollerer. Lokale modeller er det praktiske svaret:
- Suverenitet. Data som ikke kan sendes ut, kan likevel behandles. Tilgjengelighetenen på egen infrastruktur er vanskeligere å stoppe.
- Ingen binding. Vektene ligger på din disk. Ingen kan endre pris, kvote eller modell under føttene dine.
- Forutsigbarhet. Samme modell i dag og om to år. Ingen stille oppgraderinger, plutselige rate-limits eller nedprioriterte modeller.
Det ubehagelige paradokset: nesten all innovasjon på utviklingen av lokale modeller kommer i dag fra Kina, med Qwen og DeepSeek i spissen. Disse modellene slutter å bli oppdatert når Kina ikke lengre ser dem som politiske "kjepper i hjulene" på de amerikanske tilbyderne.
Suvereniteten kan ikke leies. Spørsmålet er om den kan kvantiseres.
For fire år siden: 700 GB i et datasenter
Den 30. november 2022 kom ChatGPT med GPT-3.5. OpenAI har aldri publisert størrelsen, men jeg antar rundt 175 milliarder parametere basert på det jeg har lest, for GPT-3. Kontekstvinduet var 4 096 tokens, som senere ble utvidet til 16 385 i gpt-3.5-turbo-16k, og den kjørte bare ett sted: i datasenteret.
Minnebehovet: parametere ganger bytes per vekt.
| Format | Bytes per vekt | GPT-3.5, bare vekter | A100 80 GB som trengs |
|---|---|---|---|
| FP32 | 4 | 700 GB | ca. 9 kort |
| FP16 / BF16 | 2 | 350 GB | ca. 5 kort |
| INT8 | 1 | 175 GB | 3 kort |
| 4-bit | 0,5 | ca. 88 GB | 2 kort |
Min spekulering er at gpt-3.5-turbo var en 8-bits modell som kjørte på tre A100-kort. Den ble i hvert fall merkbart raskere, og halvparten så mye minnetrafikk per token kan forklare det godt. KV-cache og kontekst kommer såklart på toppen av vektene.
De åpne modellene flytter KI ut av datasenteret
| Når | Modell | Størrelse |
|---|---|---|
| Feb 2023 | LLaMA · Meta | 7–65 mrd |
| Sep 2023 | Mistral 7B · Mistral AI | 7 mrd |
| Jun 2024 | Gemma 2 · Google | 2–27 mrd |
| Jun 2024 | Qwen2 · Alibaba | 0,5–72 mrd |
| Mar 2025 | Gemma 3 · Google | 1–27 mrd, multimodal |
| Apr 2025 | Qwen3 · Alibaba | 0,6–235 mrd, MoE |
| Aug 2026 | Qwen 3.8 Flash-Next · Alibaba | 177 mrd, 6 mrd aktive |
De tidlige åpne modellene ble kjørt i 8-bit eller 4-bit på laptoper og gamingkort. Prisen var at nyansene forsvant, særlig fra 4-bit og nedover, fordi hver eneste vekt måtte presses inn i samme antall bits.
Qwen 3.8: to veldig forskjellige dyr
Qwen 3.8-familien kom i august 2026, og de to modellene som er interessante for lokal kjøring er bygget helt forskjellig. 27B er en tett (dense) modell der alle parametere må lastes for hvert token som skal genereres. Flash-Next er en mer "glissen" Mixture-of-Experts modell der bare en brøkdel av parameterne må valideres per token generert.
| Qwen 3.8 27B | Qwen 3.8 Flash-Next | |
|---|---|---|
| Type | Tett modell | MoE, 512 eksperter (10 + 1 delt aktive) |
| Parametere totalt | 27B | 125B hovedmodell + 51B n-gram-tabell + 4B MTP |
| Aktive per token | 27B | ca. 6B |
| Arkitektur | 64 lag, 3 Gated DeltaNet : 1 Gated Attention | 48 lag, 3 Gated DeltaNet : 1 sparse attention |
| Kontekst | 262K native, opptil 1M | 262K native, opptil 1M |
| Tenkning | Kan slås av, effort low/medium/xhigh | low/medium/xhigh |
| Størrelse lokalt | ca. 16 GB i 4-bit | 66–84 GB med GSQ-RCO |
| Lisens | Apache 2.0 | Se modellkortet |
27B er arbeidshesten. Qwen rapporterer et kraftig hopp fra 3.6, blant annet 61,7 mot 53,5 på SWE-bench Pro, og den får plass på en enkelt 16–24 GB-maskin i 4-bit.
Flash-Next er beskrevet som en forhåndsvisning av arkitekturen bak Qwen4. Det spesielle er n-gram-tabellen: 51 milliarder parametere som slås opp basert på de siste tokenene, i stedet for å regnes gjennom. I standardmodellen koster denne minne, men som vi skal se lengre nede i artikkelen, kan den også leve helt fint på SSD disk uten at ytelsen blir dårlig.
Begge modellene har innebygd støtte for Multi-Token Prediction (MTP), altså en liten modell som gjetter flere tokens fremover. Behold den tanken i bakhodet, vi kommer tilbake til den om litt.
Minneveggen: én brøk styrer alt
En språkmodell som genererer tekst er ikke nødvendigvis begrenset av hvor raskt GPU-en regner, men også av hvor raskt den får data fra minnet. For hvert eneste token må alle vektene leses inn på nytt. For Qwen 3.8 27B i 4-bit er det rundt 16 GB per token.
tokens/s ≈ minnebåndbredde ÷ bytes lest per token
For eksempel: 614 GB/s ÷ 16 GB ≈ 38 tokens i sekundet
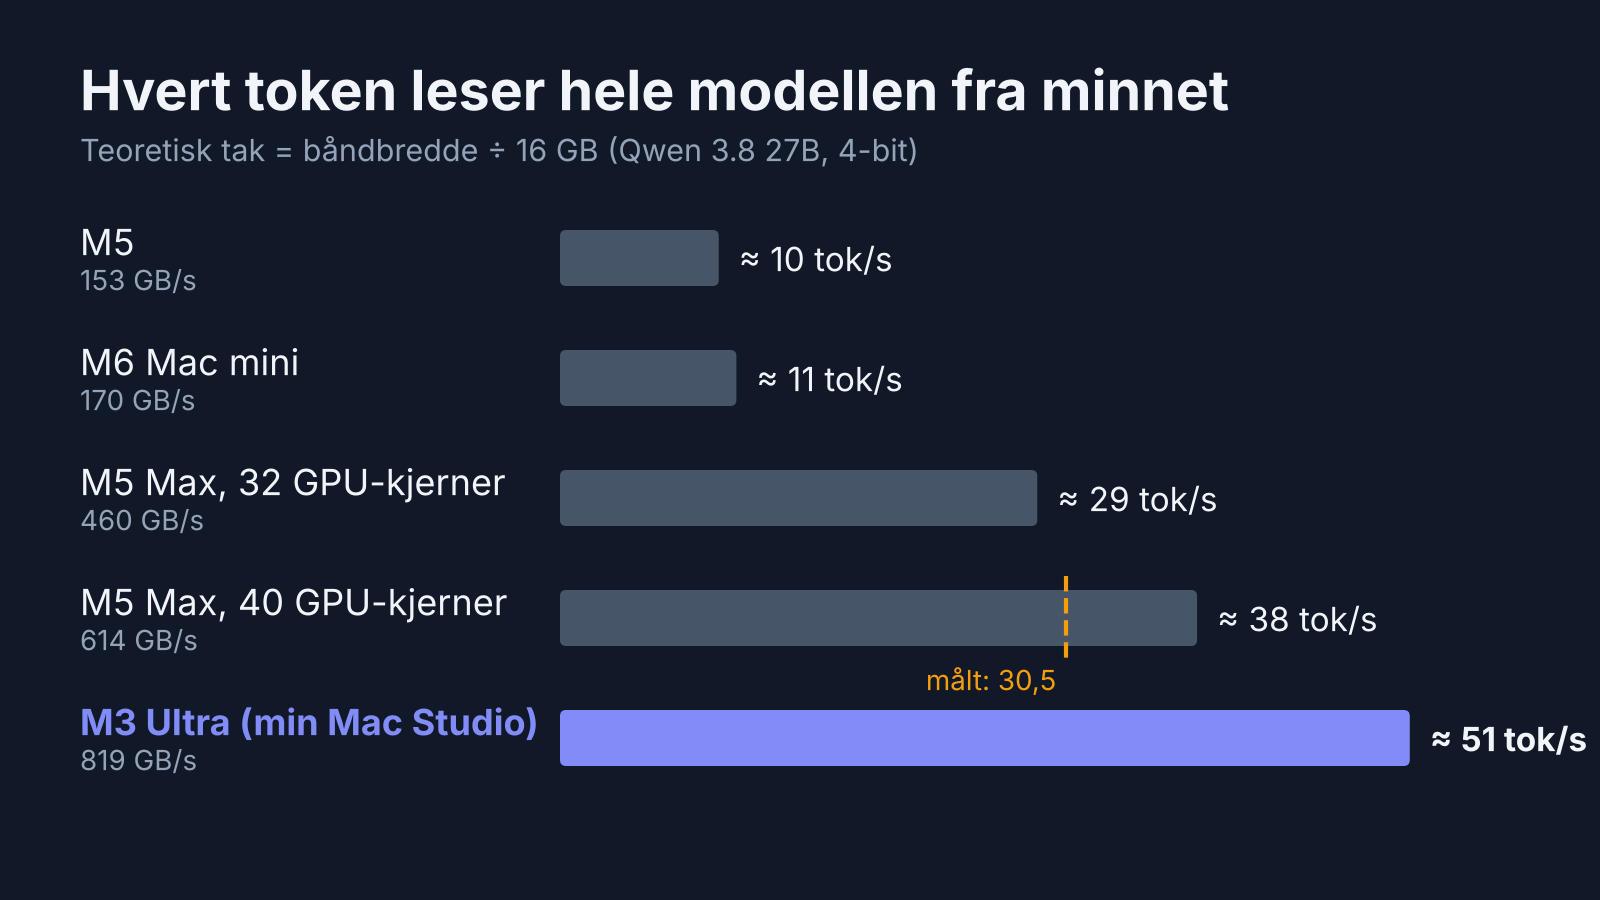
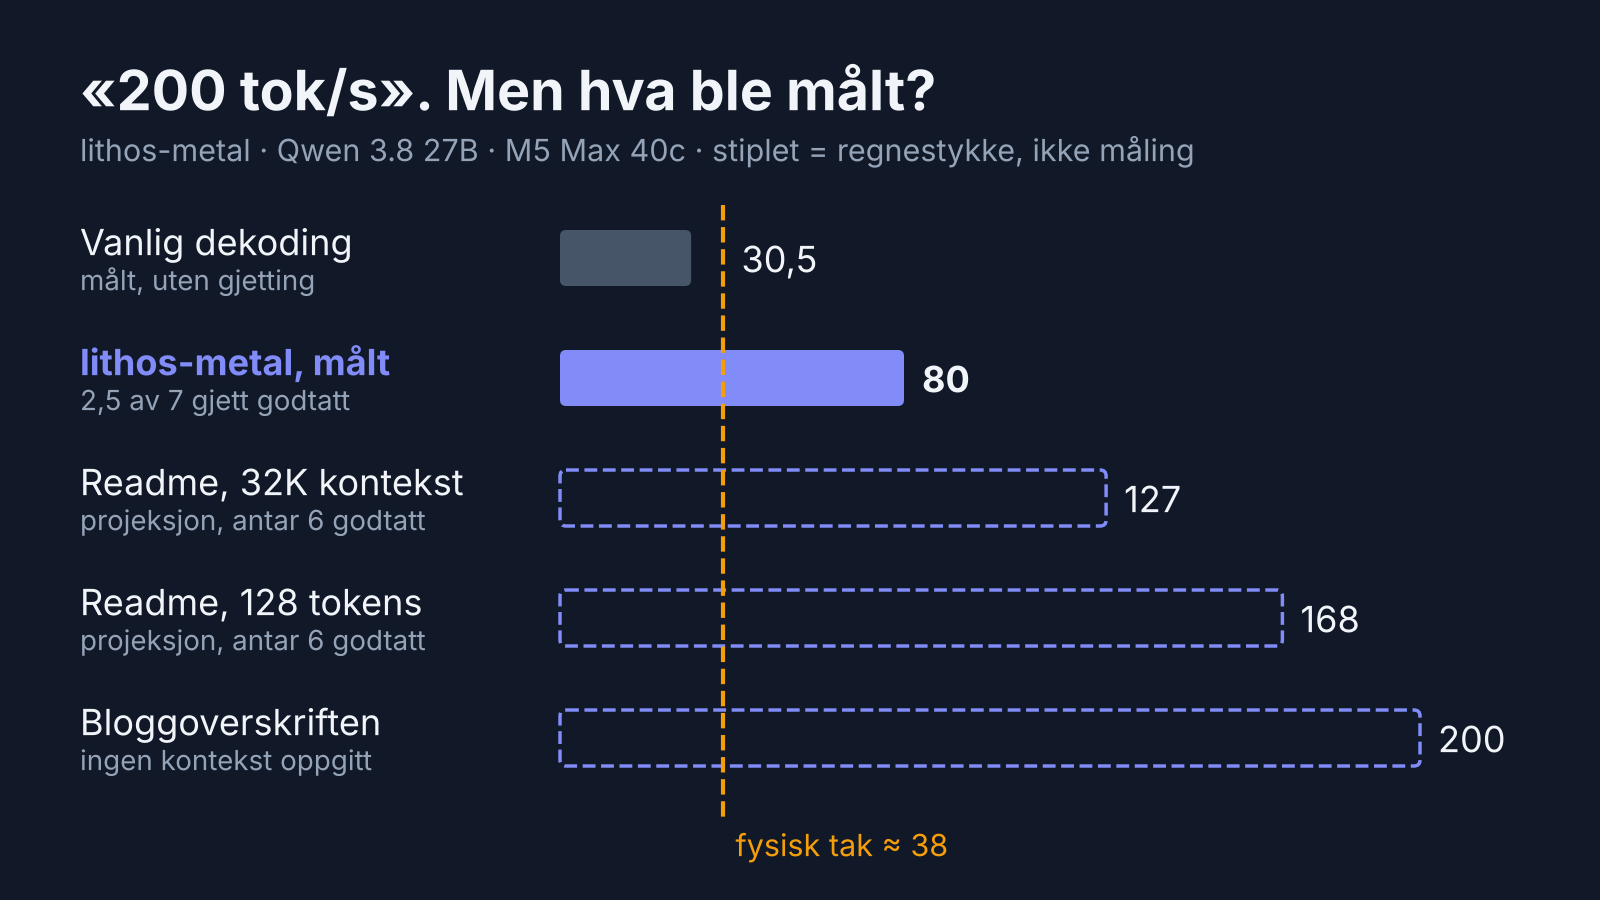
En godt bygget motor når rundt 80 prosent av taket: 30,5 tok/s målt på en M5 Max i august. Legg merke til at «M5 Max» kan bety både 460 og 614 GB/s. Min Mac Studio med M3 Ultra har 819 GB/s, og dermed et tak rundt 51.
Del 1: Krympe
Første grep er færre bits per vekt. Vi går fra 32 bits flyttall til rundt tre og en halv, uten at modellen blir dummere. For å forstå hvordan, må vi se på hva en vekt egentlig er.
En vekt er et flyttall med tre deler: fortegn, eksponent (rekkevidde) og mantisse (presisjon).
| Format | Fortegn | Eksponent | Mantisse | Totalt |
|---|---|---|---|---|
| FP32 | 1 | 8 | 23 | 32 bit |
| FP16 | 1 | 5 | 10 | 16 bit |
| BF16 | 1 | 8 | 7 | 16 bit |
| FP8 E4M3 | 1 | 4 | 3 | 8 bit |
| FP4 E2M1 | 1 | 2 | 1 | 4 bit |
BF16 beholder rekkevidden til FP32, men med mye mindre presisjon. Nederst er FP4: 16 bitmønstre og bare 15 ulike verdier, fra −6 til 6. Resten av jobben må gjøres av en skalafaktor.
Problemet: én ekstremverdi bestemmer skalaen
Med naiv 4-bit deler mange vekter én felles skala. Da tvinger én stor verdi skalaen opp for alle de andre.
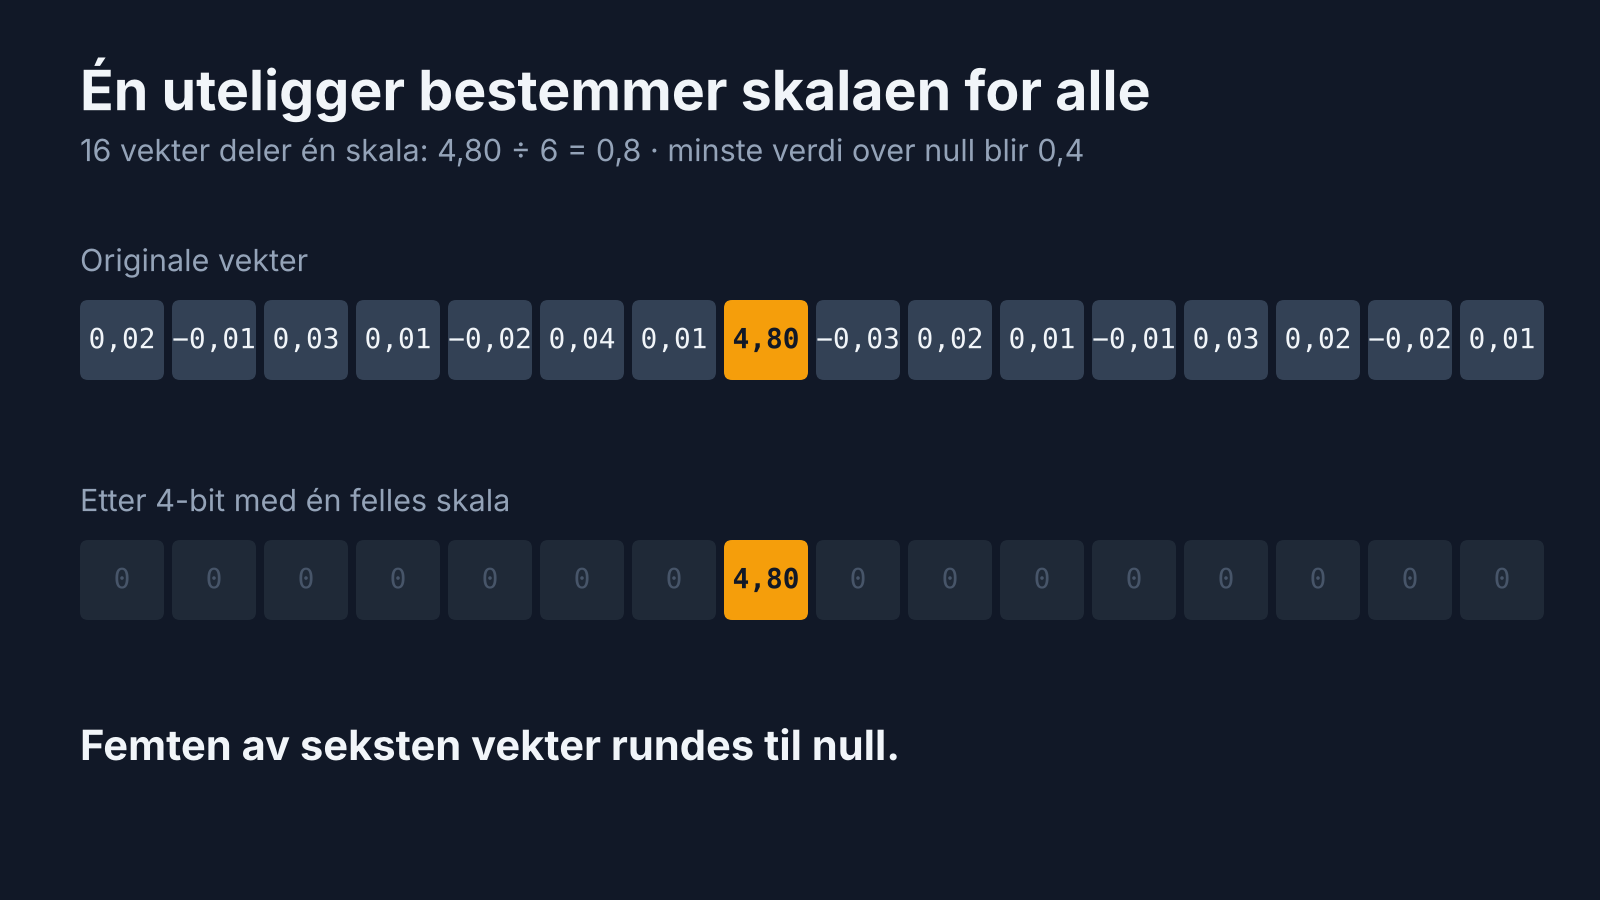
Femten av seksten vekter forsvinner. Det kan fort føre til at en naiv 4-bit implementasjon ødelegger hele modellen. Alternativet er å skalere alle vektene innenfor det 4-bit kan levere som reduserer presisjonen mellom alle vektene.
Mikroskalering: gi hver lille blokk sin egen skala
Løsningen i de nye maskinvareformatene er å dele vektene i små blokker med egen skala. Da ødelegger en ekstremverdi bare sin egen blokk, ikke hele matrisen. Kostnaden er at skalaene også må lagres og regnes ut.
| Format | Vekter per blokk | Skala per blokk | Bits per vekt |
|---|---|---|---|
| MXFP4 | 32 | E8M0, bare toerpotenser | 4,25 |
| NVFP4 | 16 | FP8 E4M3, pluss FP32 per tensor | 4,5 |
NVIDIA målte høyst 1 prosent tap med NVFP4 mot FP8 på DeepSeek-R1. Merk at sammenligningen er mot FP8, ikke FP16.
oQ4e: gi bits-ene til vektene som betyr noe
Ikke alle vekter leses like ofte. Delene som leses for hvert eneste token, koster uansett hver gang. Da kan de like godt være presise. Ekspertene som bare brukes av og til, tåler mer unøyaktighet.
Det er tanken bak oQ4e-formatet i oMLX: 8 bit der det koster mest, 4 bit på de rutede ekspertene. «e»-en betyr at en kalibreringskjøring har målt hvilke vekter som faktisk påvirker svaret.
Her går Qwen 3.8 27B fra rundt 54 GB i BF16 til rundt 17 GB, med 4,7 bits i snitt. Sammen med reduksjonen i minnebehovet går dermed også hastigheten til modellen opp.
GSQ-RCO: Dynamisk presisjon og kvantisering per tensor
Det neste steget kommer fra Østerrike. GSQ-RCO fra Deep Algorithms and Systems Lab ved ISTA, og er den mest interessante varianten jeg har sett i år.
Vanlig kvantisering gir alle tensorer samme presisjon. GSQ-RCO gir hver tensor sin egen, avhengig av hvor følsom den er:
- GSQ (Gumbel-Softmax Quantization) lærer både hvilket gitterpunkt hver vekt skal avrundes til og skalaene per gruppe. Resultatet er nær vektorkvantisering i kvalitet, men lagret i vanlige skalære formater som GGUF.
- RCO (Riemannian Constrained Optimization) velger kvantiseringstype per tensor slik at hele filen treffer en eksakt størrelse, og optimerer direkte på modellens faktiske tap i stedet for en tilnærming.
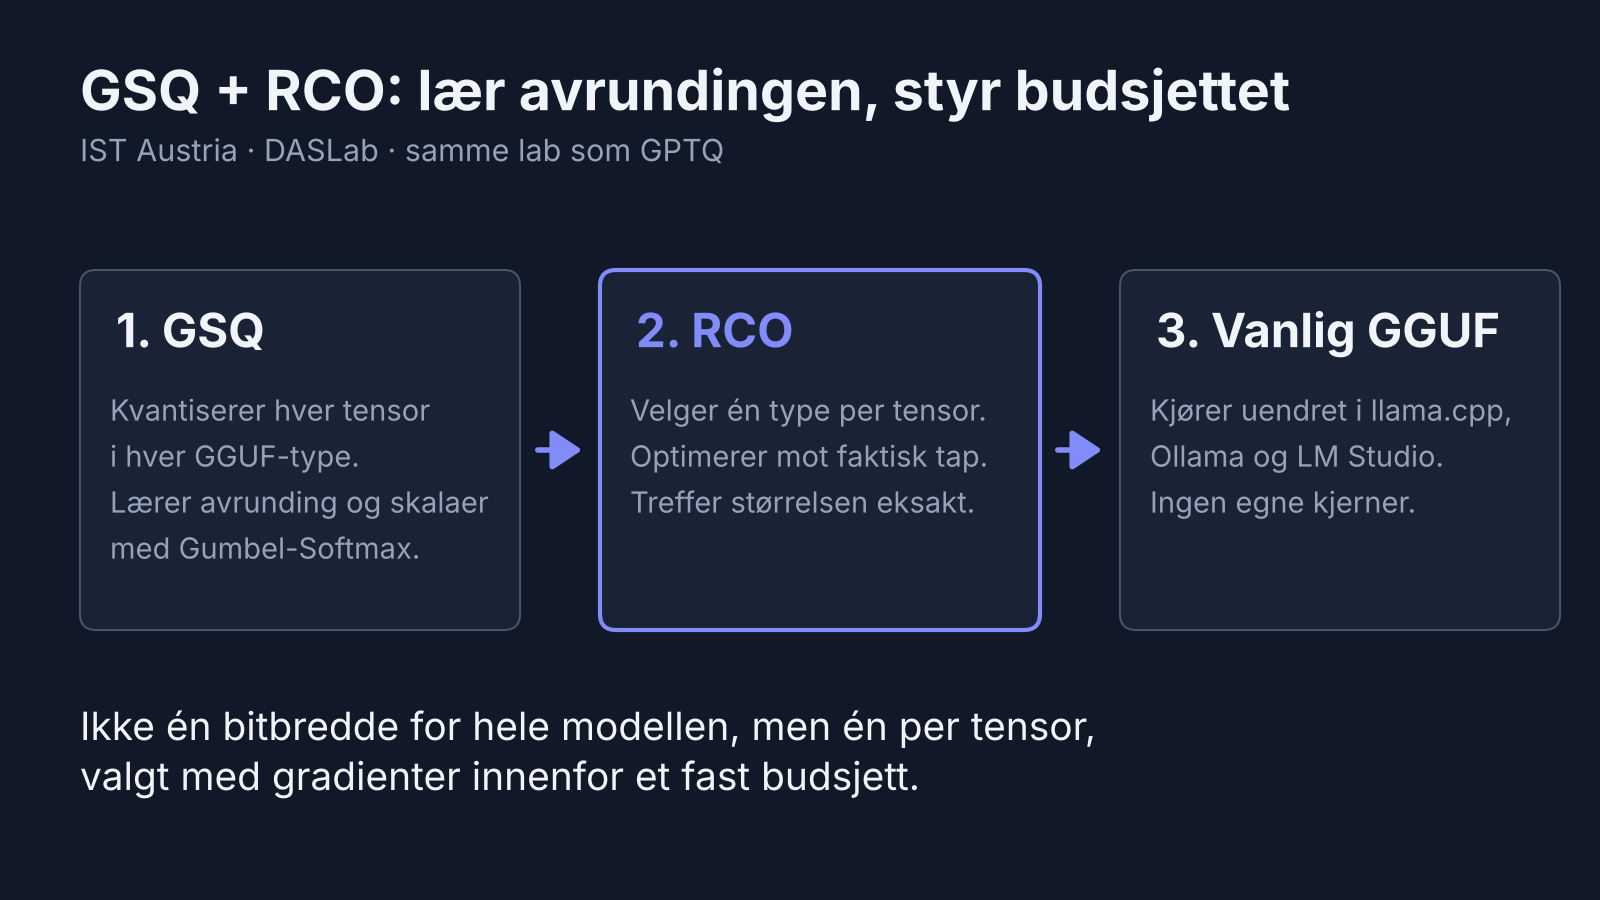
Flash-Next passer perfekt for dette. 95 prosent av vektene som søkes ligger i de rutede ekspertene, og bare 10 av 512 er aktive per token. Den store n-gram-tabellen er et oppslag, ikke en matrisemultiplikasjon, og leses bare én rad per token. Den kan derfor bli liggende på SSD-en.
| Variant | Bits per vekt | Må ligge i minnet | AIME25 | GPQA-D | LiveCodeBench v6 |
|---|---|---|---|---|---|
| BF16 (original) | 16 | 354 GB | 100,0 | 91,9 | 87,4 |
| IQ3_S (anbefalt) | 3,5 | 54,8 GB | 100,0 | 92,9 | 86,9 |
| IQ3_XXS | 3,0 | 47,0 GB | 100,0 | 91,4 | 86,3 |
| IQ2_XS | 2,5 | 39,2 GB | 96,7 | 87,4 | 83,4 |
| Q2_0 (raskest) | 2,4 | 37,6 GB | 96,7 | 89,4 | 81,1 |
Kilde: ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF. Tallene for «må ligge i minnet» er shard 1; n-gram-tabellen på 28,8 GB kommer i tillegg på disk.
Tre ting å merke seg:
- IQ3_S er på nivå med originalen på under en firedel av størrelsen.
- Formatet påvirker farten, ikke bare størrelsen. Q2_0 unngår formater med store oppslagstabeller og ga 93,8 tok/s dekoding og 3,4x raskere prompt-lesing enn IQ2_XS, som ga 70,3. Den var også mye jevnere på tvers av oppgavetyper.
- Ikke gå for lavt for agentarbeid. Benjamin Marie testet agentisk koding og fant at varianter som gjør det bra på enkle evalueringer kan falle gjennom på lange oppgaver. Hans råd: ikke under IQ3_S.
Del 2: Kutte
Andre grep er færre vekter. Flash-Next har 512 eksperter i hvert av de 48 lagene, men bare 10 er aktive per token. Avhengig av hva du skal utrette er ikke alle ekspertene like nyttige.
ISTA har derfor laget en egen Coder-variant der halvparten av ekspertene er fjernet helt. RCO velger hvilke 256 av 512 som skal bort i hvert lag, ved å måle hvor mye modellens svar endrer seg på kalibreringsdata for kode, agentisk verktøybruk, visjon og romlig resonnering.
«1,89 bit» er et snitt, ikke et nytt tallformat
Vektene som blir igjen er fortsatt 3,5 bit. Først når filstørrelsen fordeles over originalens parametertall (les: halvparten av ekspertene er fjernet), lander snittet på 1,89. Regnet baklengs er rundt 54 prosent av parameterne igjen (1,89 / 3,5). ALtså er ingen enkeltvekt lagret i 1,89 bit.
| Benchmark | BF16, 354 GB | Coder, 29,6 GB i minnet | Beholdt |
|---|---|---|---|
| SWE-bench Verified | 82,80 | 79,20 | 95,7 % |
| LiveCodeBench v6 | 87,43 | 87,43 | 100 % |
Resultatet er at modellen er god på koding, men reduksjon i ekspertene gjør at allmennkunnskapen skorter. ISTA selv rapporterer at lange agentiske oppgaver over ekte repoer beholder 95,7 prosent. Tallene er målt med xhigh-resonnering. Merk at modellen lokalt ofte kjøres med medium resonnement for å unngå 10-15 minutter lange resonneringer.
Del 3: Flytte (Engram)
Tredje grep: det modellen vet, trenger ikke ligge i raskt minne. Det holder at den finner det.
Flash-Next har en n-gram-tabell på 51 av sine 176 milliarder parametere. Det er ikke matriser som må regnes gjennom, men en oppslagstabell for kunnskap. Nøkkelen er det nåværende tokenet pluss ett eller to tokens foran. Siden oppslagsnøkkelen er kjent kan raden hentes mens maskinen regner. Derfor kan tabellen ligge på en rask SSD i stedet for i RAM.
Ideen kommer fra DeepSeeks Engram fra januar 2026, som DeepSeek selv har tatt i bruk i V4.1-Flash. Qwen krediterer ikke Engram i modellkortet, men designet er det samme (three.dev). Resonneringen skjer fortsatt i modellen. Tabellen fungerer mer som en faktadatabase den slår opp i.
I GSQ-RCO-filene ligger tabellen i en egen fil på 28,8 GB. Med -lm mmap --lazy-mode on i llama.cpp blir den liggende på disk og leses én rad per token. Det er samme tanke som Apple viste på WWDC i juni: hele modellen trenger ikke ligge i RAM.
Legger vi de tre første grepene sammen, ser fire år slik ut:
GPT-3.5-tallene er mine antakelser. Flash-Next-tallene er fra ISTA-DASLabs modellkort.
Del 4: Gjette
Fjerde grep er flere tokens per minnelesing. Hittil har vi gjort nevneren mindre. Nå deler vi regningen på flere tokens.
Spekulativ dekoding: la en junior gjette og senioren godkjenne
Trikset som bryter taket på hastighet heter spekulativ dekoding. Den store modellen krever mange GB med data for hvert eneste token, mens en liten. modell kan generere mange tokens på samme tid. Det er her tanken bak spekulativ dekoding ligger der den store modellen kan validere resultatet til den lille modellen samtidig som den genererer ett eget nytt token selv.
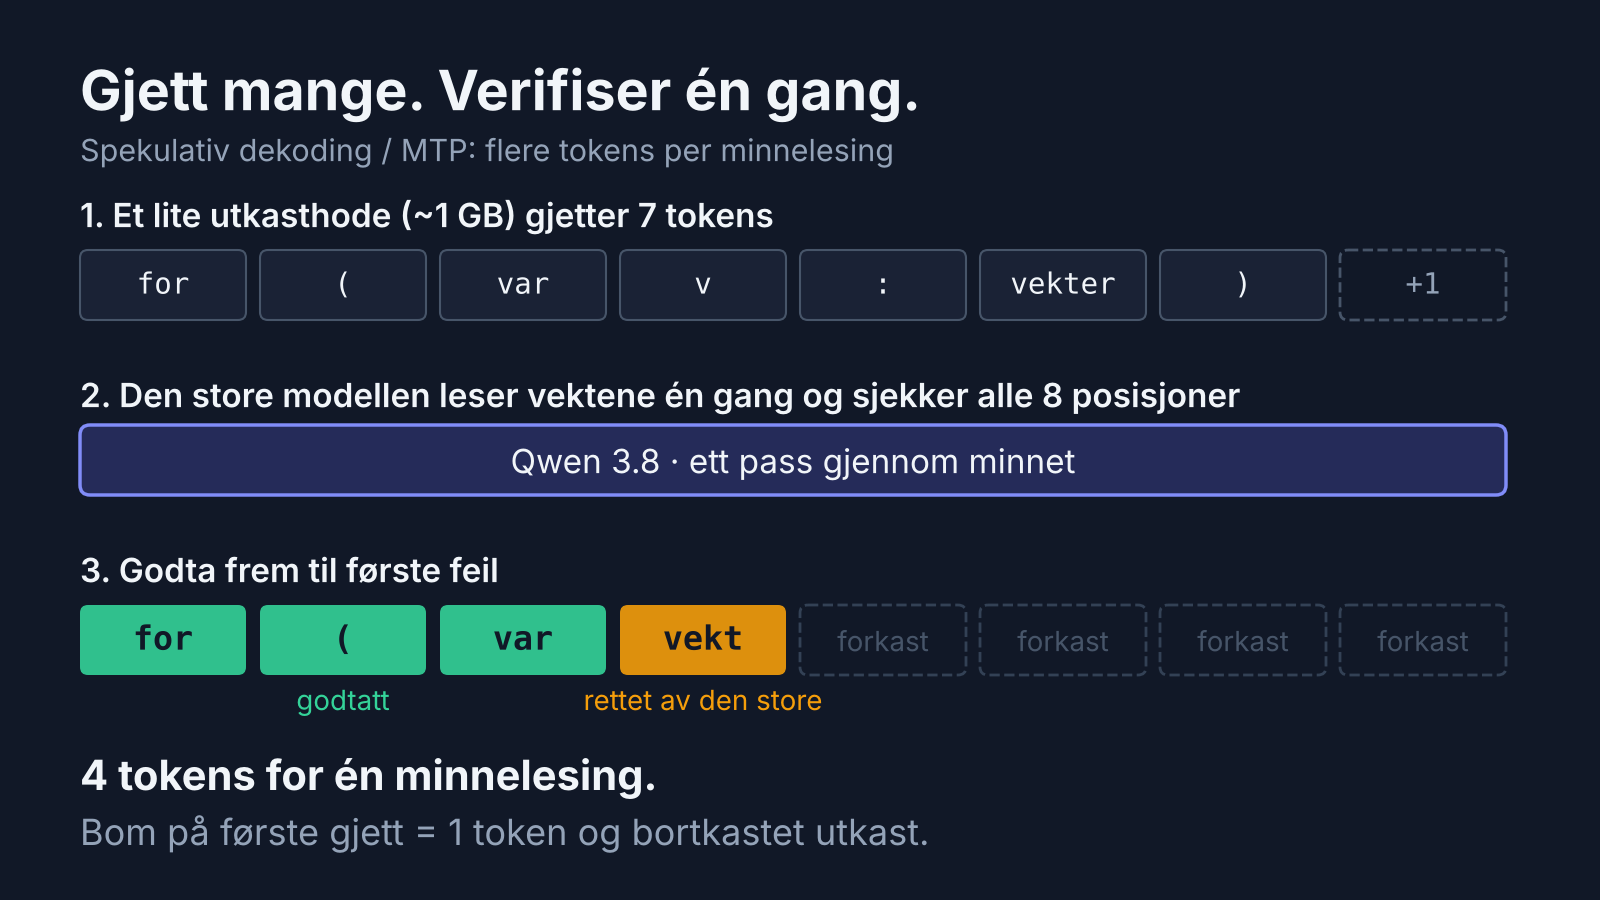
En liten utkastmodell, her DSpark på ca. 1 GB, gjetter de neste sju tokenene på noen få millisekunder. Deretter sjekker Qwen 3.8 alle i én og samme passering. Alt frem til første feil godtas, og den store modellen leverer i tillegg ett eget token til slutt i rekken.
Regnestykket er enkelt. Uten gjetting koster sju tokens rundt 112 GB lest - 16 GB per token. Med gjetting koster sju gjett rundt 7 GB og verifiseringen pluss ett ekstra token koster 16 GB. Treffer alle, får vi åtte tokens for 23 GB. Treffer ingen, får vi bare ett token for 23GB, så vi er avhengig av at minst ett token fra DSpark modellen godtas hver runde.
DSpark er DeepSeeks egen metode, publisert i juli 2026. I DeepSeek-V4 ga den 60–85 prosent raskere generering per bruker, målt mot deres forrige MTP-oppsett. Utkastmodellen for Qwen 3.8 27B er laget av andre, blant annet det lithos-metal bruker.
Tenk på det som en rask, men upresis juniorutvikler som skriver et utkast, og en treg, men alltid korrekt seniorutvikler som godkjenner linje for linje frem til første feil. Treffer junioren, publiserer dere mye på kort tid. Bommer junioren på første linje, har dere begge kastet bort tid.
To viktige poeng:
- Kvaliteten skal være identisk. Den store modellen godkjenner hvert token, så riktig implementert er spekulativ dekoding tapsfri. Bare hastigheten varierer.
- Feil gjett koster. Utkastet tar tid. Treffer det dårlig, blir du tregere enn om du aldri hadde slått på funksjonen.
200, 80 eller 34 tokens/s? Det kommer an på hva du skriver
Akseptraten bestemmer alt. Readme-filen til lithos-metal er ryddig ærlig her: 168 tok/s ved kort kontekst og 127 ved 32K er projeksjoner som antar seks godtatte gjett per runde, og som utelater tiden utkastet tar. 200-tallet i bloggposten har ingen fotnote i det hele tatt.
Kode er forutsigbart, prosa er ikke
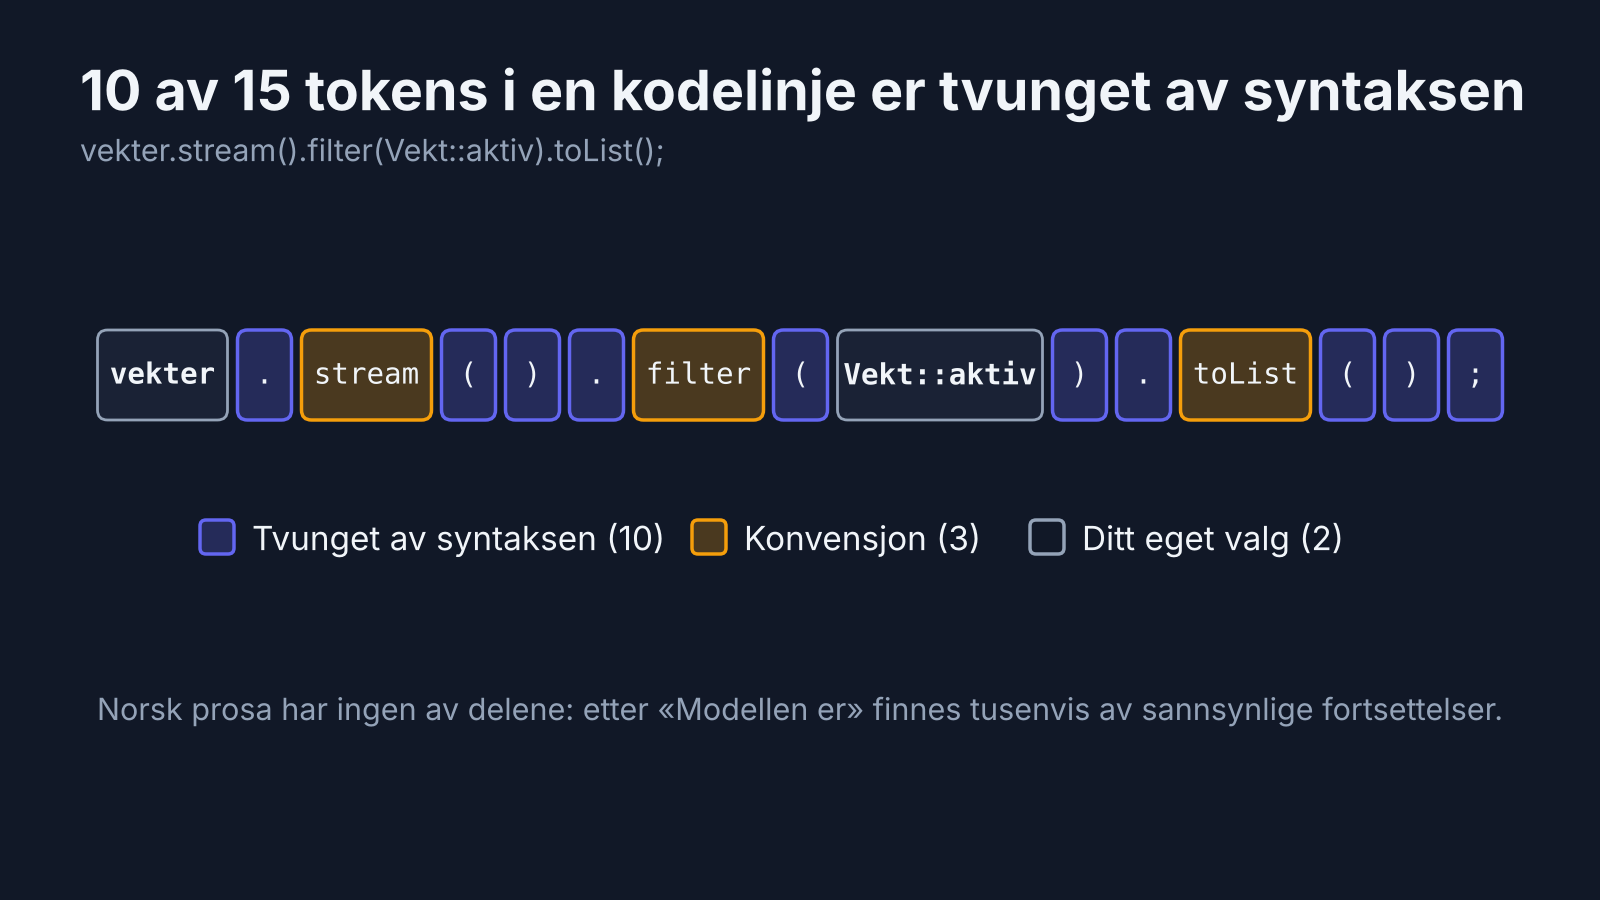
Kode er en spesiell type tekst der langt fra alle ordene er valgfrie. Den strenge gramatikken og syntaksen til koden gjør at det er enklere for den lille modellen å gjette tokens frem i tid.
Ta en helt vanlig Java-linje. Etter et navn kommer punktum, etter et metodenavn kommer parentes. stream, filter og toList er ren konvensjon. Bare to av femten tokens er egentlig ditt/modellens eget valg.
Det vises tydelig i målingene. Samme utkastmodell treffer mye oftere på kode enn på prosa:
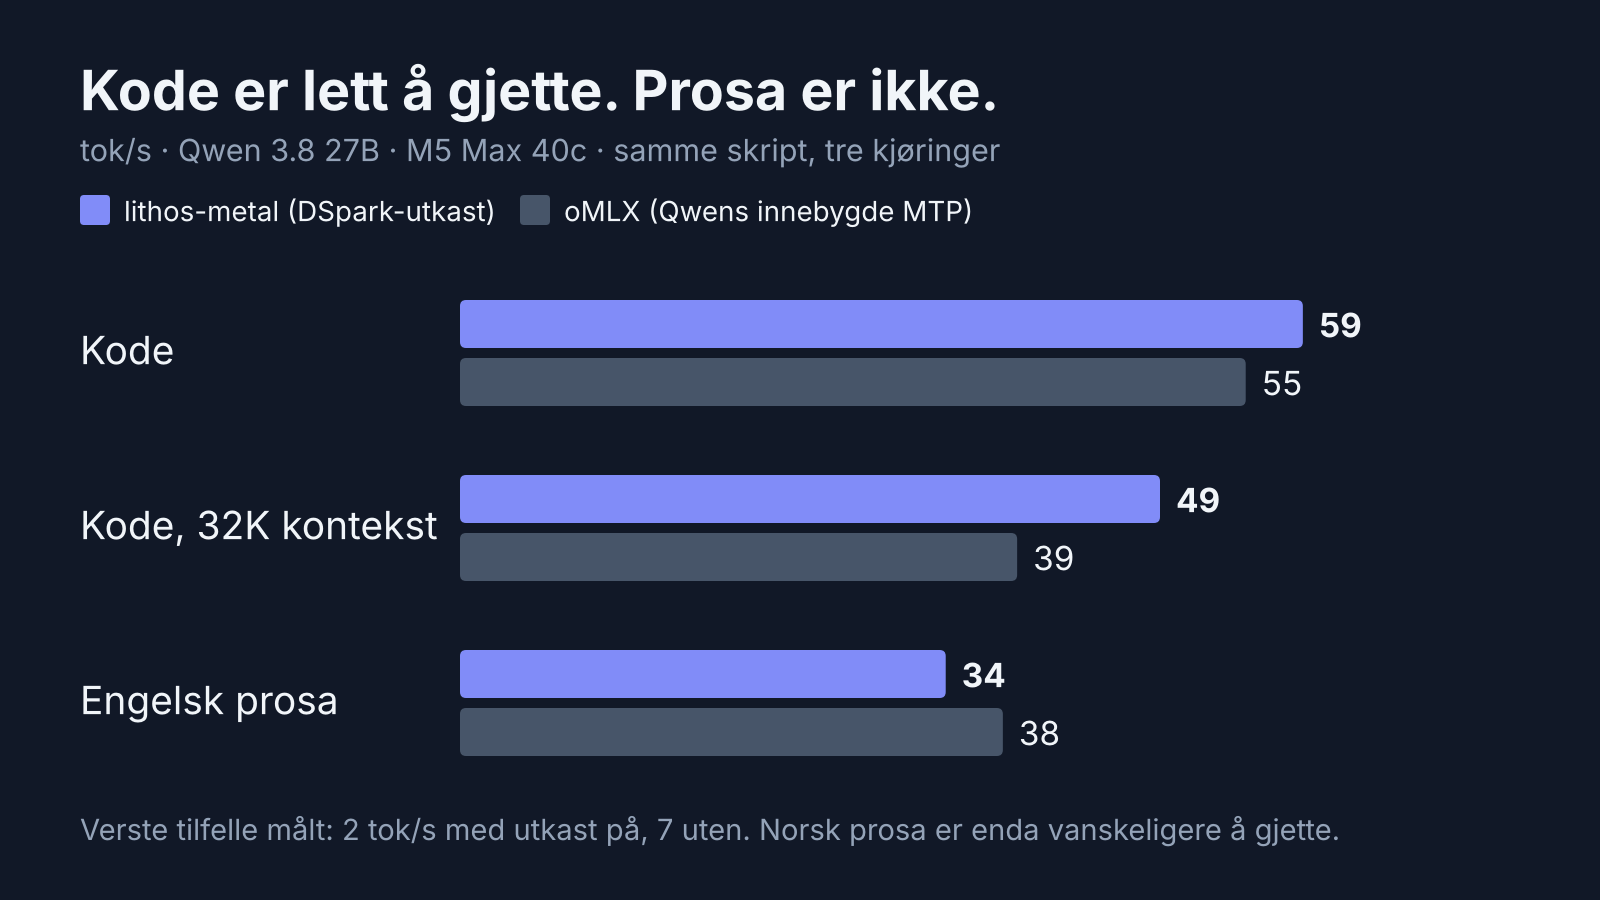
Samme maskin, samme modell, samme motor: 59 tok/s på kode og 34 på prosa. Et tilsvarende mønster er målt på M4 Pro med andre motorer: rundt 3x raskere på matte, 2,4x på kode og under 2x på chat. Det verste eksempelet: på en ikke-tunet fallback ga utkast-modus 2 tok/s på engelsk tekst, mot 7 uten. Hurtigmodus gjorde det tre ganger tregere.
For oss som skriver på norsk er dette ekstra relevant. Utkastmodellene er stort sett trent på engelsk og kode, og norsk prosa er enda vanskeligere for dem å gjette. Det finnes allerede en flerspråklig finjustering av DSpark-utkastet for Qwen 3.8 27B som gir 15–25 prosent bedre fart på ikke-engelske tekster, mot 7–12 prosent tap på engelsk kode og matte. Utdataene er like gode uansett; det er bare farten som flytter seg.
Agenter leser mer enn de skriver
Bruker du lokale modeller i agentiske arbeidsflyter, er tokens per sekund feil mål. Før modellen skriver noe, må den lese systemprompten, verktøylisten, filene og de siste tretti rundene. Den fasen heter prefill.
En kjøring av benchmarken Agent Perf Local med Qwen 3.8 27B (8 oppgaver, 168 runder) leste rundt 196 000 nye tokens og skrev rundt 31 000, selv etter caching. Seks tokens lest for hvert token skrevet.
Krympe og gjette ganger hverandre
Kvantisering gjør hver lesing mindre. Gjetting gir flere tokens per lesing. De to multipliserer hverandre, de legges ikke sammen.
Jeg målte Qwen 3.8 27B i oMLX på en M5 Max med 128 GB:
| Oppsett | Tokens per sekund |
|---|---|
| BF16 med MTP | ca. 20 |
| oQ4e (4-bit) med MTP | ca. 54 |
81 prosent av utkastene ble godtatt, 2,9 tokens per syklus. Kvantiseringen ga MTP-hodet ekstra presisjon, ellers ville gjettingen blitt dårligere. Tallene er fra én bruker, ikke en kontrollert test.
Det samme går an med Flash-Next. Det finnes allerede bygg som kombinerer GSQ-RCO IQ3_S med MTP-utkast: mindre lesinger og flere tokens per lesing, samtidig.
Konklusjon: mindre bits er ikke mindre modell
- Krympe: fra 32 til rundt 3,5 bit per vekt, med læring og ikke bare avrunding.
- Kutte: fjern ekspertene du ikke trenger, men mål det du vil beholde.
- Flytte: la kunnskapen ligge på disk. Bare resonneringen trenger fart.
- Gjette: les modellen én gang og få flere tokens. Men sjekk hva som ble målt.
700 GB i et datasenter i 2022. 29,6 GB på en laptop i 2026.
Innlegget på fagdagen ble avsluttet med en live demo av Qwen3.8 27B i Splash-motoren, samt Qwen3.8-flash-next i GSQ_RCO Coder varianten. 27B modellen yter hele 106 tokens per sekund på kode-oppgaver mens Flash-next (også med Splash motoren) skrev hele 47 tokens per sekund. Sammenliknet med 8-bit standard versjonen til Qwen3.8 27b som yter ca 15.5 tokens per sekund.
| Modell | RAM Behov | Tokens/s |
|---|---|---|
| Qwen 3.8 27b | 28G | 15,5 |
| Qwen 3.8 27b Splash | 17GB | 106 |
| Qwen 3.8 Flash-Next Splash | 38GB | 47 |
Suverenitet kan ikke leies. Men den kan kvantiseres.
Kilder
- Presentasjonen: syntakserror.no/presentasjoner
- ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF og Coder-varianten
- GSQ-artikkelen (arXiv 2604.18556) og RCO-artikkelen (arXiv 2605.00649)
- Engram (arXiv 2601.07372) og deepseek-ai/Engram
- DSpark (arXiv 2607.05147) og deepseek-ai/DeepSpec
- Qwen3.8-Flash-Next i SGLang-kokeboken
- Qwen3.8-27B i LM Studio og immers.cloud
- NVIDIA om NVFP4
- oMLX og Qwen3.8-27B-MLX-oQ4e-mtp
- lithos-metal på GitHub og wiki
- lithos-metal PR #28: raskere prefill og PR #48: 4-bit-konvertering
- LithosAI/Qwen3.8-27B-DSpark-NVFP4 og Qwen3.8-27B DSpark Multilingual
- three.dev om Engram og n-gram-minne
- Benjamin Marie om GSQ-RCO IQ3_S
- YouTube-gjennomgang av lithos-metal og Qwen 3.8 27B (transkripsjon)